Source Catalog Agent: Сценарії використання та доменні стандарти
Дані всередині підприємства рідко бувають однорідними. Різні системи використовують різні назви полів, структури та частоту оновлень для опису ідентичних бізнес-сутностей. Source Catalog Agent усуває прогали між необробленими фізичними структурами та стандартизованими бізнес-визначеннями. Цей посібник детально описує, як агент усуває семантичний дрейф (semantic drift), вирівнює схеми відповідно до доменних стандартів та підтримує критичні корпоративні сценарії використання.
Основні сценарії використання
1. Нормалізація корпоративних схем
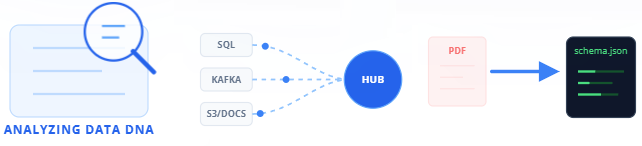
В організаціях із гібридними інфраструктурами дані надходять з реляційних платформ, черг повідомлень та файлів хмарних сховищ. Source Catalog Agent нормалізує ці метадані в єдиний стандартизований формат:
- Реляційні бази даних (JDBC/ODBC): Регуляризує визначення таблиць та деталі стовпчиків із застарілих реляційних рушіїв.
- Потокові топіки (Apache Kafka / AMQP): Сопоставляє тимчасові схеми payloads, надаючи уніфіковану структуру поруч зі статичними таблицями.
- Хмарні файли (Parquet / Avro / JSON): Перетворює атрибути вкладених схем у плоскі, зручні для запитів структури.
- Динамічні інтерфейси (REST API / Open Lineage): Перекладає логи живих payloads та події метаданих часу виконання в стандартизовані записи схем.
2. Вирівнювання семантичних концепцій
Повторюваною проблемою в управлінні метаданими є ідентифікація однакових сутностей у кількох системах. Наприклад, ідентифікатор клієнта може мати назву:
customer_idвсередині таблиці PostgreSQL, підключеної через JDBC.custIdвсередині активного топіку повідомлень Apache Kafka.Client Identifierвсередині необробленого конфігураційного файлу JSON/AVRO або специфікації PDF.
Source Catalog Agent вирішує це, запускаючи семантичний аналіз назв та форм даних. Він визначає, що ці поля представляють одну й ту саму сутність, і автоматично групує їх у реєстрі метаданих. Це дозволяє інженерам даних відстежувати лінію походження даних та встановлювати правила безпеки одночасно для баз даних, потоків та файлів.
3. Запобігання семантичному дрейфу (Semantic Drift)
Семантичний дрейф виникає, коли різні відділи надають відмінні визначення одному й тому ж полю бази даних. Наприклад, поле з назвою user_status може трактуватися як:
- Інженерія: Логічне значення (boolean), що вказує, чи підтвердив акаунт електронну пошту.
- Аналітика: Код статусу, що відстежує активність користувача в 30-денному вікні.
- Фінанси: Рівень, що класифікує акаунт для цілей білінгу.
Без чітких, спільних стандартів ці визначення розходяться, що призводить до конфліктних метрик у звітності. Source Catalog Agent запобігає семантичному дрейфу шляхом перевірки схем на відповідність бізнес-визначенням, заданим у вікі-системах, словниках даних та конфігураціях каталогів. Він приєднує чіткі, затверджені правила до технічних стовпців схем, гарантуючи, що всі команди запитують правильне поле.
Покрокова реалізація доменних стандартів
Source Catalog Agent забезпечує узгодженість даних шляхом застосування доменних стандартів безпосередньо до необроблених схем.
Крок 1: Збір доменних правил
Агент імпортує бізнес-словники, конвенції найменування та специфікації конфіденційності з ваших корпоративних словників даних або внутрішніх вікі-систем.
Крок 2: Проведення аналізу метаданих
Під час прогонів виявлення агент порівнює профілі фізичних даних із імпортованими доменними правилами:
- Він перевіряє, чи відповідають назви стовпців стандартам найменування (наприклад, snake_case vs camelCase).
- Він перевіряє, чи відповідають типи даних визначенням (наприклад, перевіряючи, що номери телефонів зберігаються як рядки, а не як цілі числа).
- Він позначає відсутні описи або відсутні категорії класифікації.
Крок 3: Вирішення структурних розбіжностей
Коли структури полів відрізняються в різних форматах даних (наприклад, стандартні плоскі структури в JDBC порівняно з глибоко вкладеними структурами в файлах JSON або Parquet), агент застосовує правила сплощення та вкладення. Це створює віртуальне представлення схеми, яке узгоджує обидва стилі.
Крок 4: Маркування чутливої інформації
Агент аналізує профілі стовпців для автоматичної ідентифікації та маркування категорій чутливих даних (таких як поля GDPR PII або CCPA compliance), узгоджуючи їх з організаційними стандартами.
Переваги: Чому це ефективно?
- Забезпечує узгоджену звітність: Усуваючи семантичний дрейф, агент гарантує, що бізнес-аналітики, розробники та керівники посилаються на ідентичні метрики.
- Спрощує міграцію: При перенесенні робочих навантажень із застарілих систем баз даних до хмарних сховищ агент зіставляє старі та нові структури, перевіряючи збереження форми та значення даних.
- Автоматизує обмеження комплаєнсу: Автоматичне маркування чутливих полів гарантує, що аудити комплаєнсу можуть миттєво знаходити PII у файлах, базах даних та потоках подій.
- Об'єднує ізольовані команди: Уніфікує інженерні, аналітичні та бізнес-групи, замінюючи окремі визначення єдиним чітким мапінгом термінології.