Data Modeling Agent: Сценарії використання та доменні стандарти
Моделювання даних у масштабі вимагає узгодження різнорідних технічних схем зі стандартизованими бізнес-концепціями. Data Modeling Agent використовує семантичний мапінг та техніки графів знань для узгодження необроблених структур із корпоративними таксономіями та регуляторними моделями. Цей посібник охоплює те, як агент підтримує бізнес-сценарії та впроваджує основні доменні стандарти.
Підтримувані доменні стандарти
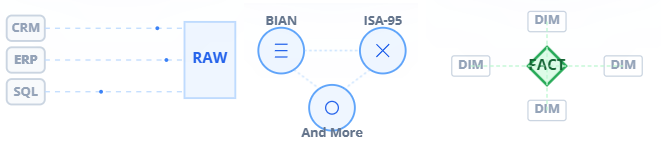
Data Modeling Agent має вбудовану доменну експертизу для перекладу та узгодження необроблених вхідних баз даних із провідними глобальними стандартами:
- BIAN (Banking Industry Architecture Network): Визначає складні, вкладені структури фінансових послуг, домени послуг та контрольні записи. Агент представляє BIAN як логічний граф, зіставляючи необроблені транзакції з канонічними банківськими концепціями.
- ACORD Info: Стандартна модель для страхової галузі. Агент стандартизує визначення полісів, страхових випадків та клієнтів у застарілих базах даних та файлах.
- ARTS (OMG): Стандарти Асоціації роздрібних технологій. Агент зіставляє профілі роздрібних клієнтів, логи транзакцій та дані про товарні запаси з уніфікованими схемами.
- OMOP CDM (Observational Medical Outcomes Partnership Common Data Model): Основна модель у сфері охорони здоров'я. Агент зіставляє медичні записи, ідентифікатори ліків та події пацієнтів у стандартні таблиці для клінічних досліджень.
- ISA-95: Міжнародний стандарт для інтеграції корпоративних систем та систем управління у виробництві. Агент структурує ієрархію обладнання, матеріальні ресурси та графіки виробництва.
- TM Forum SID (Shared Information/Data Model): Референсна фреймворк-модель для телекомунікаційного сектору. Агент зіставляє угоди передплатників, метрики використання та моделі білінгу.
- IEC 61970: Спільна інформаційна модель (CIM) для управління енергетичними системами. Агент перекладає фізичні конфігурації мереж, структури генерації та моделі розподілу у зручні для запитів бази даних.
Основні корпоративні сценарії використання
Агент допомагає організаціям стандартизувати, запитувати та керувати визначеннями своїх даних.
1. Семантична нормалізація схем
Організації опрацьовують дані з різноманітних платформ, таких як реляційні бази даних, потокові черги та хмарні файли. Агент зіставляє ці вхідні дані зі стандартними визначеннями:
- Банківські системи: Перетворює різні ID клієнтів із застарілих баз даних у сумісну з BIAN схему "Business Partner".
- Системи охорони здоров'я: Автоматично перебудовує регіональні EMR-записи в уніфікований макет OMOP CDM.
- Телекомунікації: Стандартизує дані використання клієнтів із застарілих мереж у сумісні з TM Forum SID логи.
2. Вирішення конфліктів сутностей та найменувань
Агент оцінює схеми для пошуку еквівалентних сутностей за допомогою семантичного аналізу. Наприклад, він визначає, що cust_acc_no (JDBC), ClientNo (payload Kafka) та accountNum (схема Avro) вказують на одну й ту саму логічну концепцію. Він об'єднує їх під стандартним ідентифікатором, дозволяючи суміжним системам об'єднувати набори даних без ручного виявлення.
3. Запобігання семантичному дрейфу (Semantic Drift)
Семантичний дрейф виникає, коли бізнес-підрозділи визначають поля по-різному (наприклад, Маркетинг визначає "лід" за датою реєстрації, а Фінанси — за підтвердженням оплати). Агент вирішує це шляхом порівняння таблиць схем із задокументованими правилами словника, попереджаючи про невідповідності та приєднуючи чіткі бізнес-визначення до технічних стовпців.
Покрокова реалізація доменних стандартів
Агент забезпечує дотримання цих стандартів через автоматизований робочий процес узгодження на основі графів:
Крок 1: Збір стандартів та ініціалізація графа
Агент завантажує бажаний стандарт (такий як BIAN або OMOP CDM) як семантичний референсний граф. Вузли представляють стандартні сутності та поля, тоді як ребра визначають зв'язки та правила перевірки.
Крок 2: Парсинг та профілювання схеми джерела
Агент сканує схему клієнта (бази даних, файли або повідомлення) для вилучення назв стовпчиків, типів даних, можливості використання NULL та первинних ключів.
Крок 3: Мапінг семантичного узгодження
Агент запускає семантичні модулі зіставлення поверх розібраних схем. Він оцінює назви стовпчиків та розподіл даних, порівнюючи їх зі стандартними концепціями в референсному графі. Наприклад, якщо він знаходить стовпчик із 9-значними значеннями, схожими на номери соціального страхування, він зіставляє його зі стандартним полем ідентифікації.
Крок 4: Генерація коду трансформації схеми
Після мапінгу агент генерує сумісні зі стандартами оператори DDL або dbt-трансформації. Це перетворює необроблені staging-дані на цільові моделі без ручної розробки коду.
Крок 5: Перегляд та каталогізування метаданих
Мапінг реєструється в каталозі метаданих для верифікації, дозволяючи вам відстежувати кожне фізичне поле назад до його стандартного визначення.
Переваги: Чому це ефективно?
- Прискорений комплаєнс та галузеве узгодження: Ручне узгодження даних із фреймворками, такими як BIAN або OMOP CDM, займає місяці рецензування архітекторами. Агент використовує моделі графів для автоматизації цього мапінгу.
- Узгоджена міжсистемна аналітика: Стандартизуючи визначення, агент гарантує, що звіти з різних систем використовують однакові метрики.
- Зменшені ризики семантичного дрейфу: Автоматизована перевірка звіряє проєкти схем із глосаріями доменів, сповіщаючи інженерів про потенційні помилки до розгортання коду.
- Крос-галузева гнучкість: Незалежно від обробки фінансових, виробничих, медичних або енергетичних даних, багатостандартна база знань агента адаптується до домену вашої організації.